AMD携手Unsloth:XDNA 2 NPU正式支持本地运行350亿参数大模型
Unsloth是一个专注于开源AI工具的开发团队及项目,早期主要凭借提升大语言模型训练与微调效率而受到关注,之后逐步拓展至模型运行和部署领域。Unsloth Desktop是其推出的跨平台桌面应用,提供图形化操作界面,用户无需复杂的命令行配置,即可下载、管理并在本地训练或运行多种AI模型,还能通过兼容OpenAI API的接口向其他软件提供本地模型服务。
2026年11月19日,Unsloth和AMD宣布达成合作,将在Unsloth Desktop中新增对搭载XDNA 2架构的AMD Ryzen AI NPU的支持。这使XDNA 2成为全球首个正式获得Unsloth Desktop支持的NPU架构,进一步拓展了AMD端侧本地AI推理的应用场景。
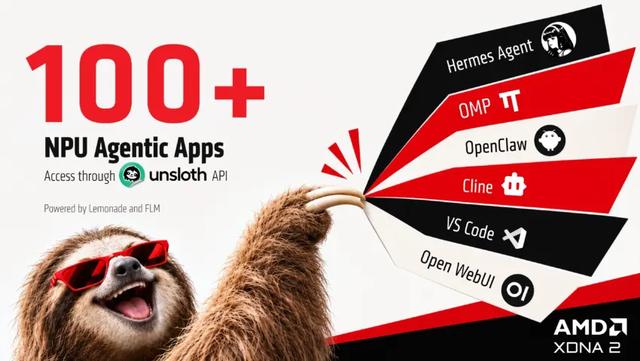
在软件实现层面,Unsloth Desktop通过集成Lemonade与FastFlowLM(FLM),为受支持模型提供本地服务,并将推理计算调度至XDNA 2 NPU执行。由此,模型推理负载主要由NPU承担,CPU与GPU则可继续处理智能体编排、前端交互及其他多种应用任务。
本次适配同步提供兼容OpenAI API规范的本地接口,超过100款兼容的智能体应用与工作流均可调用该本地推理服务,包括Hermes Agent、OpenClaw、Open WebUI、Cline、OMP以及Visual Studio Code等工具。依托这一标准化接口,上层应用无需单独开发NPU推理引擎,即可接入Unsloth Desktop提供的本地大模型推理能力。
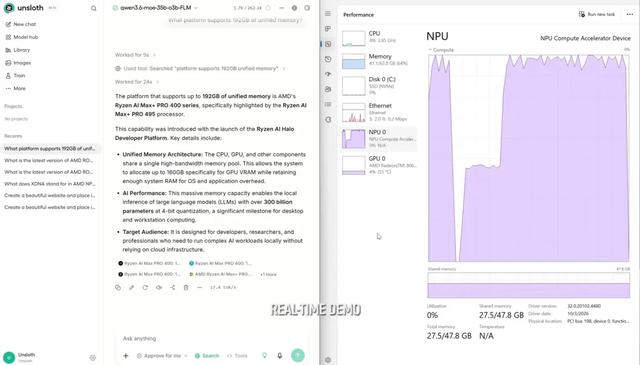
AMD演示了Qwen3.6-35B-A3B稀疏混合专家(MoE)模型在XDNA 2 NPU上的推理表现。该模型总参数量为350亿,每个Token约激活30亿参数。演示表明,受支持模型的推理计算可由专用NPU承担;但模型服务、应用编排等环节仍由软件及主机系统协同完成。按照AMD公布的数据,该模型在完整上下文配置下运行,需要约28GB可供NPU使用的共享内存。
根据AMD给出的部署说明,Windows默认共享内存分配比例为50%,因此官方建议整机配备64GB系统内存,以满足该模型完整上下文配置下的内存需求。用户可在Unsloth Desktop的模型中心,通过新增的NPU筛选项检索并下载适配NPU推理的模型,再按提示启用NPU并加载模型。
NPU加速方案的核心价值在于能效表现。AMD表示,将受支持的AI推理负载转移至专用NPU,有助于降低CPU和GPU在模型推理环节的资源占用,使其继续承担智能体规划、多任务调度及其他应用任务。
相较于持续占用通用计算资源,NPU更适合承担低功耗、持续性的AI推理工作,有望降低本地AI智能体长时间后台运行的能耗,并改善搭载Ryzen AI处理器的移动设备在电池供电状态下的续航表现。具体功耗与续航表现仍取决于机型、模型及实际负载等条件。
本次发布是AMD与Unsloth此前合作的延伸,2026年7月,双方已推动Unsloth支持AMD GPU平台,覆盖消费级Radeon显卡、Ryzen AI Max平台以及Instinct系列加速卡,支持本地模型训练、微调与推理。此次XDNA 2 NPU的加入,使AMD本地AI硬件生态进一步形成GPU与NPU并行的推理布局,为端侧AI应用提供更多算力选择。
小编将在第一时间分享更多相关最新动态和爆料,敬请关注。
评论 共 0 条 · 0.24s